进入 21 世纪的第二个十年,互联网在变革的社会中孵化出了越来越多的新服务,电商... 展开 >
融合趋势下的大数据技术
会议室:水晶厅出品人:周家英
- Topic 1
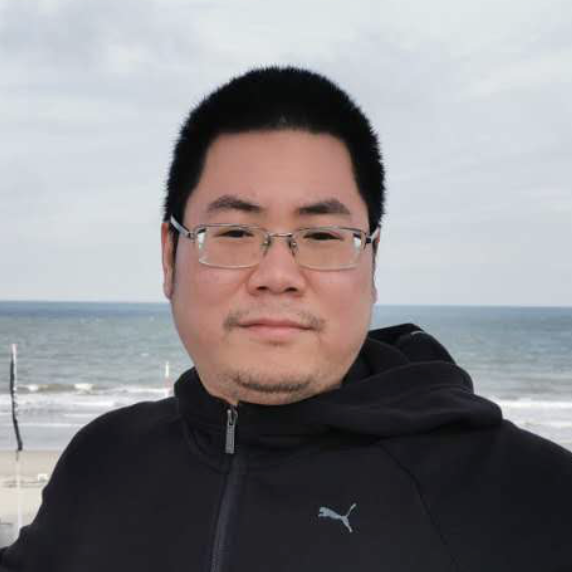
潘臻轩(泰初)
蚂蚁集团 高级技术专家 - Topic 2
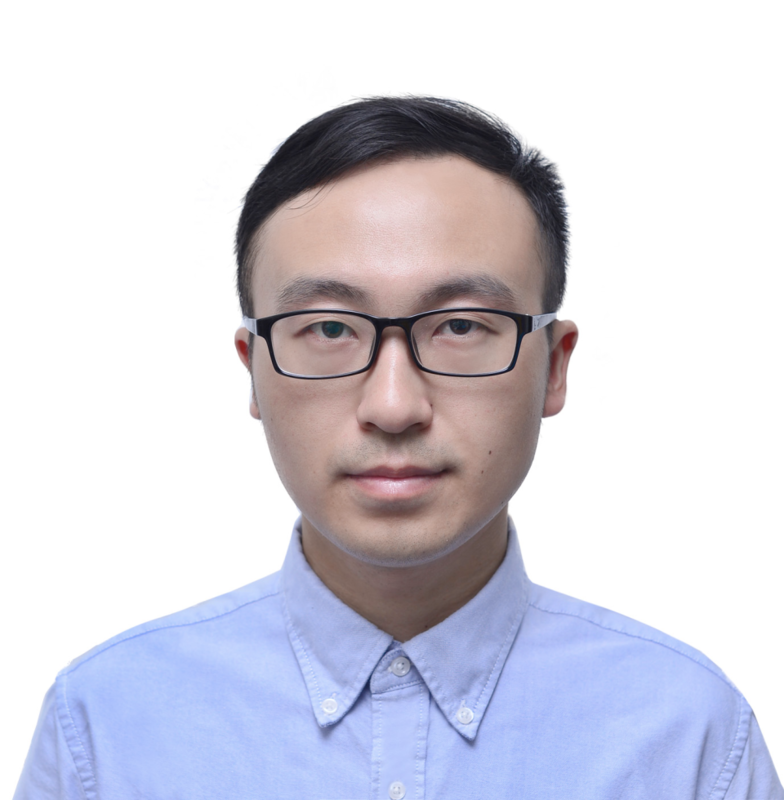
杨华
T3 出行 大数据平台负责人 - Topic 3
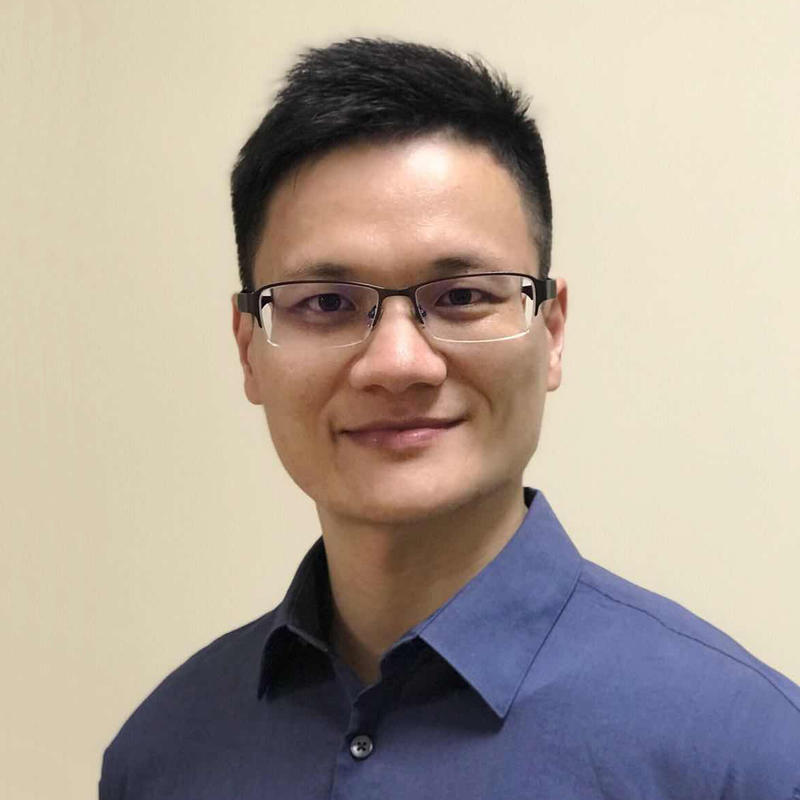
谢巍盛
翼支付 大数据总监 - Topic 4
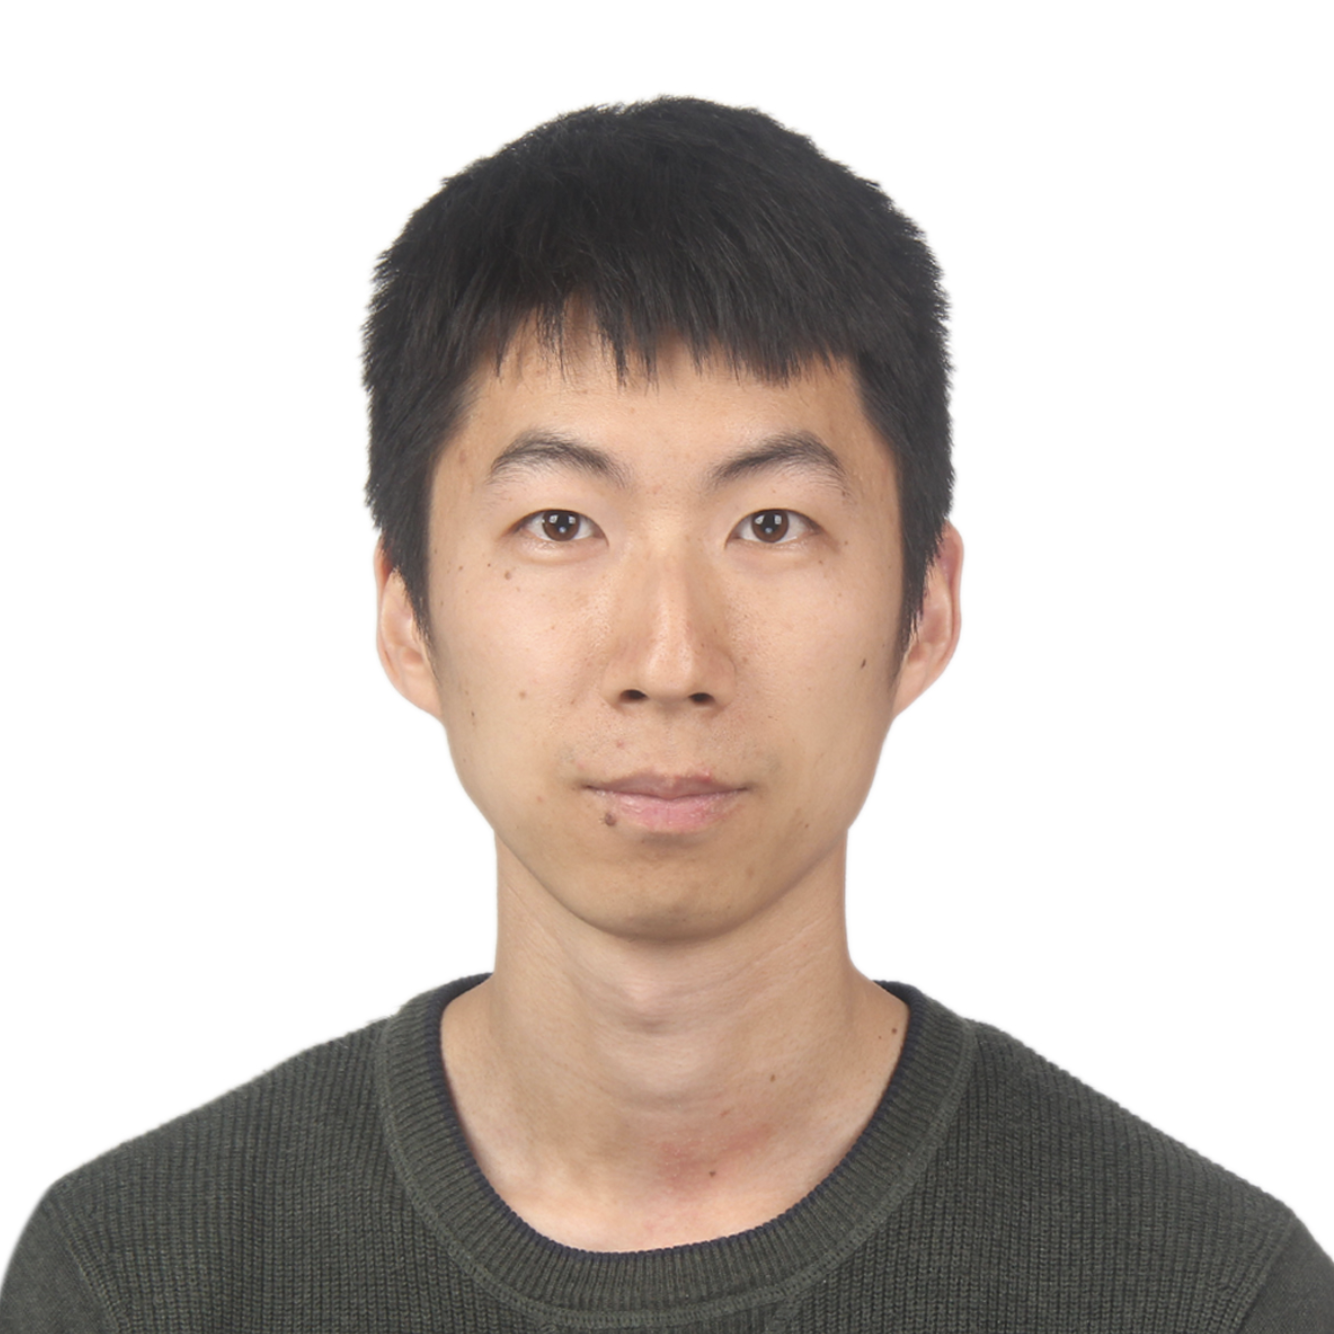
汪愈舟
英特尔 高性能数据分析团队研发经理 - Topic 5
郑志升
bilibili 大数据实时平台负责人 - Topic 6
邵赛赛
腾讯 数据湖内核技术负责人、资深大数据工程师 - Topic 7
郭俊
字节跳动 数据引擎团队负责人 - Topic 8
章剑锋
阿里巴巴 高级技术专家
专题出品人:周家英
蚂蚁集团 资深技术专家
周家英(徒离),蚂蚁集团资深技术专家,现负责数据技术部在线计算团队。2011 年加入支付宝后,一直参与支付宝数据相关工作。经历了蚂蚁集团从离线数据,实时数据,到目前在线数据的不同的阶段,参与过蚂蚁实时数据平台,Serverless Streaming,在线作业调度,计算元数据,以及新一代计算引擎的建设。熟悉蚂蚁数据技术架构演进历史,对分布式环境下的在线计算场景及高可用方案有切身体会。
地点:水晶厅
专题:融合趋势下的大数据技术
进入 21 世纪的第二个十年,互联网在变革的社会中孵化出了越来越多的新服务,电商直播,互联网金融,同城外卖等等……而所有互联网服务背后的基础永远是大数据。同时在 2020 年,大数据技术也从 2005 年以 Google 为首的三驾马车时代开始进入了第三个 5 年。在这个过程中,计算类型从迭代计算延伸到流式计算再到交互计算;存储时效性从离线到实时及目前的在线;运维体系从单一作业调参到全局作业优化……越来越多的大数据系统及解决方案百花齐放、层出不穷。
而在企业实际应用中,随着数据业务复杂度的提升,一个场景往往需要多种计算及存储互相配合才能完成。业界对大数据的需求已经从开始的单计算、单存储,逐渐走向了复合计算及多态存储。本次专题,我们就邀请了诸多国内外一线互联网及科技企业,分享各自在融合趋势下的新一代大数据技术。期待可以通过大量系统设计及应用案例为大家呈现一场技术盛宴。
by 潘臻轩(泰初)
蚂蚁集团
高级技术专家在金融领域中,金融实体关系天然适合图模型进行描述,比如资金关系、企业关系等。因此图计算广泛应用在金融领域的各个方面,于此同时,随着对图数据的时效性要求越来越高,我们在蚂蚁集团构建了一套实时图计算系统支持了蚂蚁多个应用场景。
内容大纲
1. 实时图计算的典型场景
- 实时的安全风控
- 推导得到实时图计算的能力需求
2. 蚂蚁实时图计算系统
- 传统实时计算和图计算的现状
- 蚂蚁实时图计算系统核心能力
- 实时图计算系统的应用价值
3. 实时图计算未来的思考
- 实时图数据场景和应用
- 实时图计算未来的价值
听众收益
1. 了解实时图计算场景背后的核心诉求
2. 了解蚂蚁实时图计算系统
3. 理解实时图计算的价值和能力
适合人群
对实时计算或图计算比较感兴趣的人群。
by 杨华
T3 出行
大数据平台负责人Apache Hudi 是由 Uber 开源的在分布式文件系统上提供对大型分析数据集的摄取、管理以及查询的数据湖框架。2019 年 1 月加入 Apache 孵化器进行孵化,加入孵化器大半年,发布第一个 Apache 版本后就快速被 AWS EMR 团队集成进 EMR 5.28.0 发布版,它也是 Amazon EMR 集成的开源项目里唯一一个还处于孵化阶段的项目。Hudi 在 Uber 从 2016 年开始研发到 2017 年上线生产环境,已构建远超 100 PB 的数据湖、单表 1000 个 Pipeline、每天处理 100TB 的数据规模。
本次分享我们将会对 Hudi 框架的功能、特性以及使用场景进行全面且系统地介绍。同时,我们将介绍 Hudi 在 T3 出行相关场景中的实践。Hudi 是一个包容且开放的社区,我们还将介绍社区正在进行中的 Hudi 与 Flink 计算引擎集成相关的工作。
听众收益
- Apache Hudi 介绍
- 为什么 Hudi 是构建数据湖正确的选择
- Hudi 在 T3 出行的落地实践
- Hudi 社区的 RoadMap 以及跟 Flink 集成的进展
适合人群
OLAP、数据仓库以及大数据计算、分析相关的从业人员。
by 谢巍盛
翼支付
大数据总监由于业务模式不固定,企业在发展初期往往是以相对独立的开发和运营模式开展各条线业务,以更灵活高效地响应市场需求,但随着业务发展带来体量和复杂度的上升,烟囱模式带来的重复建设导致企业成本攀升,也因各业务缺乏协同,制约了企业的市场竞争力。我们尝试用越来越受企业关注的“中台建设”来解决这些问题,本次分享将围绕企业级大数据平台、数据体系及智能化体系展开,分享翼支付数智中台建设的实践与经历。
内容大纲
一、数据时代下传统企业面临的问题
- 烟囱式架构带来的重复建设导致企业成本高
- 企业内部缺乏协同导致能力无法沉淀与共享
- 数据无法统一治理导致数据交付质量低
- 资源分散, 流程繁杂导致需求响应时效差
二、金融企业的数智化转型升级之路
- 大数据平台规划与建设
- 数据体系的规划与建设
- 智能化体系的规划与建设
- 企业在文化, 组织和管理的协同
三、启发与思考
- 企业数智化建设如何进行效益评估
- 中台化建设敏捷管理模式的利与弊
听众受益
- 介绍翼支付数智化升级的几个建设阶段及面临的问题
- 在大数据平台, 数据体系及智能化体系建设中的技术选型
- 中台建设中敏捷管理模式的利与弊
by 汪愈舟
英特尔
高性能数据分析团队研发经理大数据和AI经过多年的发展,在各自的生态中涌现出了大量优秀的框架,包括大数据领域中的Spark,Flink等,AI领域中的Tensorflow,PyTorch和Horovod等等。随着计算能力的提高以及人们对模型训练的更高要求,大数据和AI的融合成为一个必然的趋势。在一个典型的端到端应用中,人们使用大数据框架来进行数据的预处理和特征的提取,然后使用深度学习框架数据进行模型的训练。在传统的架构中,大数据和深度学习使用两个不同的集群,造成大量的数据移动和运维负担,应用程序也被割裂成多个框架的代码。因此,业界也尝试了一些例如Tensorflow on Spark,Horovod on Spark的解决方案将深度学习训练运行在大数据集群中,但是它们只适合特定的应用场景。为了解决这些挑战,我们基于通用的分布式计算框架Ray,研发并开源了RayDP,将大数据生态中的Spark和Flink等框架运行在Ray上,并且通过Ray的分布式对象存储,将这些大数据框架和Ray上的其它AI库比如RaySGD进行无缝的集成,从而构建一个通用的端到端大数据和AI平台。
内容大纲
一、大数据和AI融合趋势和业界的解决方案
二、我们为什么需要一个通用的分布式计算框架
1. Ray
- 什么是Ray
- Ray的架构和API
- Ray的分布式训练库RaySGD
2. RayDP
- 什么是RayDP和以及它的主要功能
- Spark-on-Ray的架构
- 使用RayDP构建一个大数据和AI的端到端应用
听众受益
- 了解大数据和AI融合的解决方案
- 了解Ray和它的设计初衷
- 了解RayDP以及如何通过它打造下一代端到端的大数据和AI平台
by 郑志升
bilibili
大数据实时平台负责人伴随着 B 站多元化的高速发展,企业内部对数据的需求也变得越发强烈,数据集成作为大数据领域的建设基石,一方面要能覆盖采集复杂繁多的数据源,另一方面还要做到在万亿规模的数据体量下保障数据传输质量。本次演讲主要分享 B 站从数据的上报,边缘采集,实时传输,到流式分发的全链路一体化架构演进。核心内容要点包括边缘传输的架构实现,基于 Flink 流批一体的实时分发架构,以及超大规模下的稳定性保障方案与建设。
内容大纲:
- 传输体系面临的挑战
- 边缘化传输架构的落地
- 基于 Flink 实时分发架构的挑战
- 全链路数据高压下的稳定性保障建设
听众收益:
- 了解大数据的整条传输分发链路
- 了解数据的采集体系是如何在复杂需求的机制下构建的
- 了解 Flink 流批一体的架构如何解决数据集成领域的各种问题
- 了解数据在万亿规模下如何打造高性能和高可用的综合型管道化服务
by 邵赛赛
腾讯
数据湖内核技术负责人、资深大数据工程师随着大数据存储和处理需求的多样化,如何构建一个统一的数据湖存储,并在其上进行多种形式的数据分析,便成了企业构建大数据生态的一个重要方向。如何能快速、一致、原子性地在数据湖存储上构建起 Data Pipeline 是一个亟待解决的问题。为此 Uber 开源了 Apache Hudi,Databricks 提出了 Delta Lake,而 Netflix 则发起了 Apache Iceberg 项目,一时间这种具备 ACID 能力的表格式中间件成为了大数据、数据湖领域炙手可热的方向。相比于 Hudi、Delta Lake,Iceberg 正式提出了表格式这样一个概念,如何利用表格式来有效地组织数据、提供 ACID 能力、优化对象存储,使之成为数据湖上一个不可缺少的一环呢?本次演讲将会具体介绍 Iceberg 的设计初衷、优点和实现方式,您将会对表格式这一领域有充分的了解。
内容大纲
1. 数据湖的现状和业界趋势
2. 数据湖中间件 – 表格式
- 表格式的出现和兴起
- 为什么需要表格式
- 业界竞品和现状
3. Iceberg
- 什么是 Iceberg
- Iceberg 的设计原理
- 事务性语义
- 为什么我们选择 Iceberg
4. 我们所做的工作
5. 业界趋势和后续规划
听众受益
- 了解数据湖表格式这一概念,为什么要提出这一概念以及它带来的意义
- 了解 Iceberg 的设计、实现、优势和使用方式,能够窥探到这一领域的发展和演变
适合人群
对开源大数据领域、大数据计算、存储组件有基本的了解,想要进一步了解某一组件的内部原理和实现。
by 郭俊
字节跳动
数据引擎团队负责人在字节跳动数据仓库领域,Spark SQL 已经取代 Hive 成为了主要的计算引擎。目前 Spark SQL 每天处理千万亿级数据。数据引擎团队针对线上复杂的场景,以及用户对于稳定性及性能方面的需求,进行了大量的优化,包含 SQL 层优化、执行层优化、Shuffle 优化、列式存储优化等。
在字节跳动内部,列式存储在数仓领域广泛使用。目前字节跳动主推的列式存储格式是 Parquet,同时存在部分使用 ORC 的场景。本次演讲,将介绍字节跳动数据引擎团队如何通过列式存储上的一系列优化加速 Spark SQL 从而更好支撑 EB 级数仓。
内容大纲
1. 列式存储基本原理及常见优化方向(高效压缩、向量化读、Late Materialization、Invisible Join)
2. Parquet 支持复杂数据类型向量化读及 field pruning
3. 物化列大幅提升复杂数据类型的读取及过滤效率
3. 自定义 Parquet 索引
4. LocalSort 提升压缩比并优化查询性能
5. IO并行化:并行读小文件,并行读大文件 Row Group
6. 异步 Spill
听众受益
1. 了解列式存储常见优化方法
2. EB 级数仓下列式存储优化实践
by 章剑锋
阿里巴巴
高级技术专家大数据行业已经发展了 10 多年,各种框架层出不穷,解决了规模,性能的问题。但是在具体实践当中,如何测试你的大数据 Job,如何从开发阶段转换到生产阶段仍然存在很多痛点。这次演讲主要是给大家介绍我们如何将 Zeppelin 和 Airflow 整合起来解决这个问题。在 Zeppelin 里,你可以交互式地写代码,实现你的 Job,并且可以比较容易的验证你的 Job 的正确性。同时利用 Airflow,你无需重新打包,经过简单的配置就可以把在 Zeppelin 写的代码非常容易的部署到生产环境。Zeppelin + Airflow 带给你的不仅是效率和易用性,而且还是一套完整的大数据最佳实践。
内容大纲
1. 大数据开发到生产的痛点
2. 分别介绍 Zeppelin 和 Airflow 的架构应用场景
3. 如何整合 Zeppelin 和 Airflow 做到大数据开发阶段到生产阶段的无缝切换
4. 最佳实践
听众收益
1. 理解 Zeppelin 的整体架构和适合的应用场景
2. 学到如何利用 Zeppelin + Airflow 来解决大数据开发阶段到生产阶段转换的痛点。
适合人群
大数据开发人员,大数据分析人员。
关注主办方(InfoQ)


交通指南
上海虹口三至喜来登酒店
Beijing International Convention Center
地址:上海市四平路59号

Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询


电话咨询
联系电话:86+ 17310043226

微信联系我们