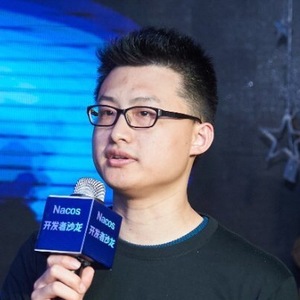
专题演讲嘉宾:李艳林
阿里巴巴微服务高级技术专家
by 李艳林
阿里巴巴
微服务高级技术专家阿里机器实例规模从十万级达到百万级的时候,注册中心的性能受到严重挑战,并且大规模推送给客户端性能带来极大消耗,业务频繁上下线过程中产生频繁推送,会造成客户端 Full GC。
从万级到十万级做了读写分离,十万级到百万级做了数据分片。为了降低推送对客户端影响做了增量推送,服务列表变化之后只推送变化的数据,首次全量推送采用压缩推送,频繁变更采用聚合推送。性能提升十倍,频繁上下线发布场景对客户端内存开展优化数十倍。
演讲提纲:
- 软负载发展历史
- 百万规模挑战
- 技术方案:
- 数据分片存储,解决写瓶颈问题
- 增量推送 & 聚合推送,解决推送报文太大或者推送太频繁导致客户端 GC 频繁问题
- 压缩推送&推送流控,解决大规模推送网卡被打满问题
- 推送优先级,解决核心业务优先推送问题
- SLA 体系,解决推送 RT 量化问题
- 未来趋势-拥抱云原生:
- 通过 MCP 协议与 Istio 打通,支持 Mesh 体系
- 通过 LacalnodeDNS 增强 CoreDNS 高可用
听众受益点:
- 了解微服务发展脉络,及其不同规模下的挑战
- 分布式系统遇到性能挑战的架构演进思路
- 如何构建高可用,高性能的分布式系统
- 了解微服务未来发展方向
关注主办方(InfoQ)


交通指南
杭州·JW万豪酒店
Renaissance Beijing Capital Hotel
地址: 杭州拱墅区湖墅南路28号

Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:86+ 13167596032

微信联系我们