2010 年获中国科学院研究生院软件理论博士学位后加入中国移动研究院用户行为实验室,历任算法工程师、项目经理、实验室技术负责人。2015 年加入亿瑞互动科技(北京)有限公司任技术 VP,负责大后端+自适应学习系统的研发工作。2017 年以合伙人身份加入 DataPipeline 任 CTO,负责公司的产品技术研发工作,有 10 项发明专利。DataPipeline 通过研发的一系列实时数据技术协助用户构建以业务目标为导向的数据链路,实现企业级实时数据管理目标。公司已加入 Linux 基金会旗下项目 OpenMessaging,主要参与 OpenMessaging Connect 接口标准制定和 Runtime 的开发及优化工作。此外也还积极参与 Kafka、RocketMQ、Flink 等开源项目的社区工作,做过多次社区 Meetup 分享。
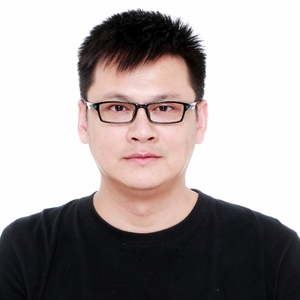
专题演讲嘉宾:陈肃
DataPipeline 产品技术部 CTO
by 陈肃
DataPipeline
产品技术部 CTOKafka 因其高吞吐低延迟特性在数据集成领域有着广泛的应用。DataPipeline 作为一款面向企业私有化部署的数据集成产品,在其架构中也将 Kafka 作为可选的数据缓存和分发组件。将 Kafka 用在私有化部署中会面临一些独有的挑战,包括数据完整性、一致性、日志留存管理以及性能调优等等。本次分享我将分享 DataPipeline 多年应用 Kafka实战中的心得总结,包括如何防止数据丢失和重复,如何对日志留存进行动态管理以防止数据的意外回收、集群容量及可用性规划等方面。
演讲提纲:
1. 硬币的两面:应用 Kafka 的收获与代价
2. 通过合理的可用性规划保证数据完整性
3. 数据处理的至少有一次 vs 恰好有一次
4. 动态日志留存管理的实现方法
5. 减少 topic partition 数量增长对性能的影响
你将获得:
- 了解应用 Kafka 带来的好处和代价
- 掌握 Kafka 集群规划的基本方法
- 了解实现数据一致性处理的逻辑
关注主办方(InfoQ)


交通指南
来广营·朝来科技园
Laiguangying Beijing
地址: 北京市朝阳区来广营朝来科技园

Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:+86 13167596032

微信联系我们